文章目录 23 个章节
背景
研究并尝试落地 Voice Agent 已经一两个月了。这段时间调研了不少产品,包括之前参考的 Tana、Codex,也体验了豆包这样的对话 App,还看了一些框架,比如 Pipecat、LiveKit、TEN。
我想做一个会议助手,能和我们聊天,看懂共享的文档,再帮忙查资料、创建任务。最近打算分几篇整理这段时间的研究和尝试:
- 模型接入:Voice Agent 需要语音识别、文字和视频画面理解、语音合成这些能力。先从模型的选择和组合入手,尝试做出接近真人的对话效果。
- Prompt 与工具调用:让助手遵循业务规则,在信息不足时追问、执行前按需确认,并通过工具把对话中的要求变成实际操作。
- 记忆与上下文:把会议中讨论的文档、任务和前面的发言提供给 AI,并随着讨论推进保留和更新相关信息。
- 多轮会话与轮次控制:处理用户的停顿、补充和改口,让助手连起几轮对话,掌握倾听和回应的时机。
- 打断与恢复:助手被打断后,停止旧回复、理解新的要求,并处理还在执行的工具。
这一篇先从模型开始,聊聊我看过的接入方式、尝试的模型组合,以及目前的选择和感受。
两种语音对话的接入方式
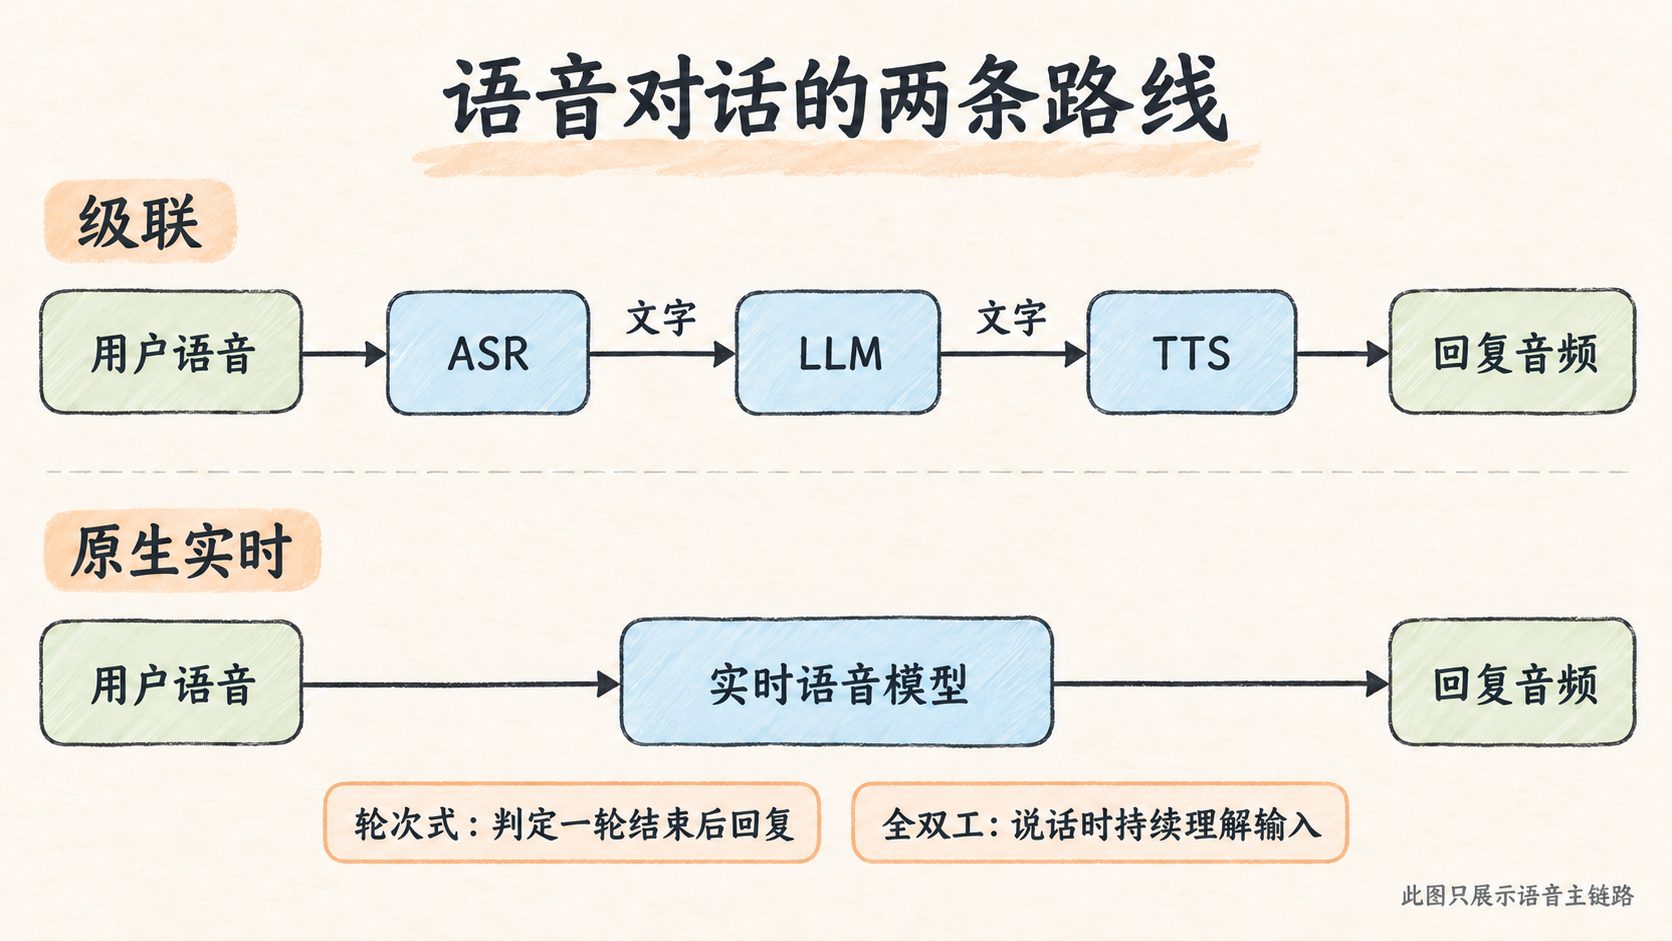
之前写 Pipecat 时介绍过级联,后来继续研究,才发现还可以直接接入原生实时模型。语音能力主要有这两种接法:
- 级联:把 ASR、LLM 和 TTS 串起来,完成语音识别、理解和语音合成。
- 原生实时:直接接入能理解和生成语音的模型。按对话方式,还可以分为轮次式和全双工。
级联:ASR + LLM + TTS
级联的实现包含以下三个部分:
- ASR(语音识别):把用户的声音转成文字。
- LLM:结合上下文理解问题,生成回答,或者发起工具调用。
- TTS(语音合成):把回答转成声音,播放给用户。
如果还需要看画面,可以抽取视频或屏幕中的图片,交给支持视觉的模型。
级联的好处是各部分可以单独选择。听错了,查转写;回答不合适,看 LLM;声音不好听,调整 TTS。代价是应用要协调更多环节,而且声音转成文字后,原来的语气、音高等信息不会自动保留下来。
级联也可以让用户随时插话。通常由应用或 Pipecat、LiveKit 这类框架检测用户开口,取消旧回复、停止播放,再处理新的输入,不需要全部从零实现。
原生实时模型:直接处理语音
平时调用文本 LLM,我们传入文字,拿回文字。原生实时模型则直接接收声音、生成语音,应用不用再串接 ASR、LLM 和 TTS。模型能听到语气和节奏,回答时也能带上情绪。
同样一句“行吧”,爽快地答应和犹豫着接受,意思就不太一样。只传文字容易丢掉这部分信息。直接处理语音还能减少几个服务之间的等待,这也是我想尝试这条路线的原因。
但 Realtime 不等于全双工。按 LiveKit 的分类,原生实时模型还可以分成两类:
- 轮次式实时模型(Turn-based):先判定用户这一轮说完了,再生成回答。轮次可以由服务端的语音或语义检测判断,也可以由应用触发。用户中途插话时,可以取消旧回答,再处理新的输入。
- 全双工实时模型(Full-duplex):模型在生成语音时,仍持续理解正在输入的声音,结合上下文判断继续说、等待或让用户先说。
国内外都有对应的代表模型,具体要看版本:
| 对话方式 | 国内代表 | 国外代表 |
|---|---|---|
| 轮次式 | 豆包上一代端到端语音模型(Seeduplex 之前,官方称为半双工) | OpenAI GPT Realtime 2.1、Google Gemini 3.8 Live |
| 全双工 | 豆包 Seeduplex、Qwen3.8-Omni-Flash-Realtime | OpenAI GPT-Live 1、Kyutai Moshi(开源) |
能打断,不代表模型本身能边听边说。 连接同时收发音频,也不等于模型在同时理解和生成。全双工把更多对话时机的判断放进模型里;应用仍要配合停止播放、清理旧回复,并处理正在执行的工具。
豆包 Seed 团队介绍 Seeduplex 时,有一句话很贴合我想要的效果:
面对用户的思考犹豫,模型能耐心倾听
这篇介绍里,Seeduplex 重点改善的是这些对话问题:
- 停一下就被抢话:结合声音和上下文区分思考停顿与发言结束,给用户留出补充的时间。
- 旁边有声音就被打断:区分对助手说的话与背景噪声、无关对话,减少误回复和误打断。
- 用户插话后还继续说:说话时持续理解用户的声音,识别打断意图并让出发言。
Seeduplex 已经用在豆包 App 的语音通话里。这里说的是它的具体改进,轮次式系统也可以通过语义检测等模块减少抢话和误打断。
我想要的其实就是平时聊天的感觉:
- 说完一句,它能快点接上,语气也自然一点。
- 聊到一半想补充,就直接插一句,不用等它把整段话念完,也不用每次都想好一段完整的话再开口。
全双工模型的底层有什么不同
其实我当时看到全双工模型时,也挺好奇:它的底层架构是怎么实现的,还是 Transformer 吗?
全双工模型也可以基于 Transformer。相比常见文本 LLM 的一问一答,它需要在生成语音时持续处理新输入,并学会接话、等待和让话。
比如开源的 Moshi,在文本 LLM 的基础上加入音频编解码器,把用户和助手的声音作为两路流一起建模,再通过对话训练学习停顿和打断。Seeduplex 也基于 LLM 底座,但具体实现不能直接套用 Moshi 的架构。
如果感兴趣,可以查看以下链接:
两种路线的取舍
LiveKit 对这三类架构做了对比(下图为中文译制):
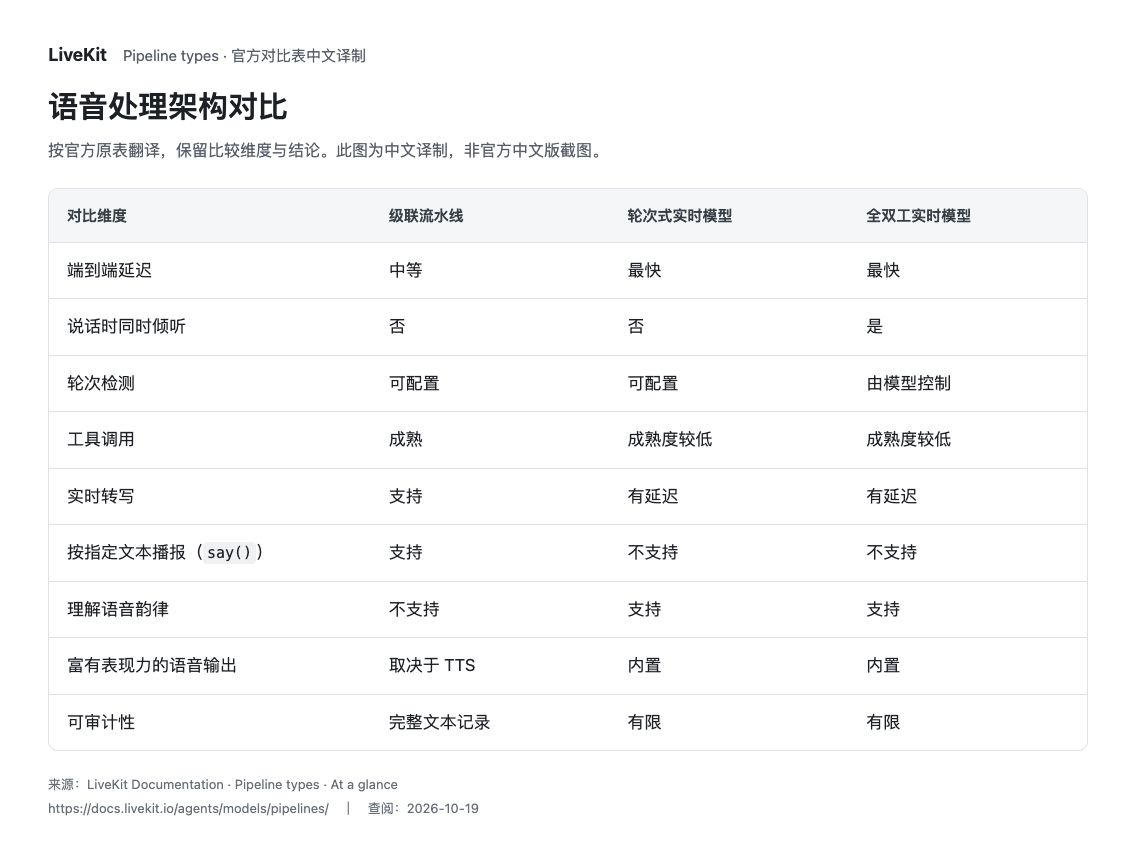
我更想把对话做自然,但我们的助手还得看屏幕、调用业务工具,也要考虑调用费用,所以不能只听几句回答就决定用哪个模型。
不同接法下的 Agent Loop 控制权
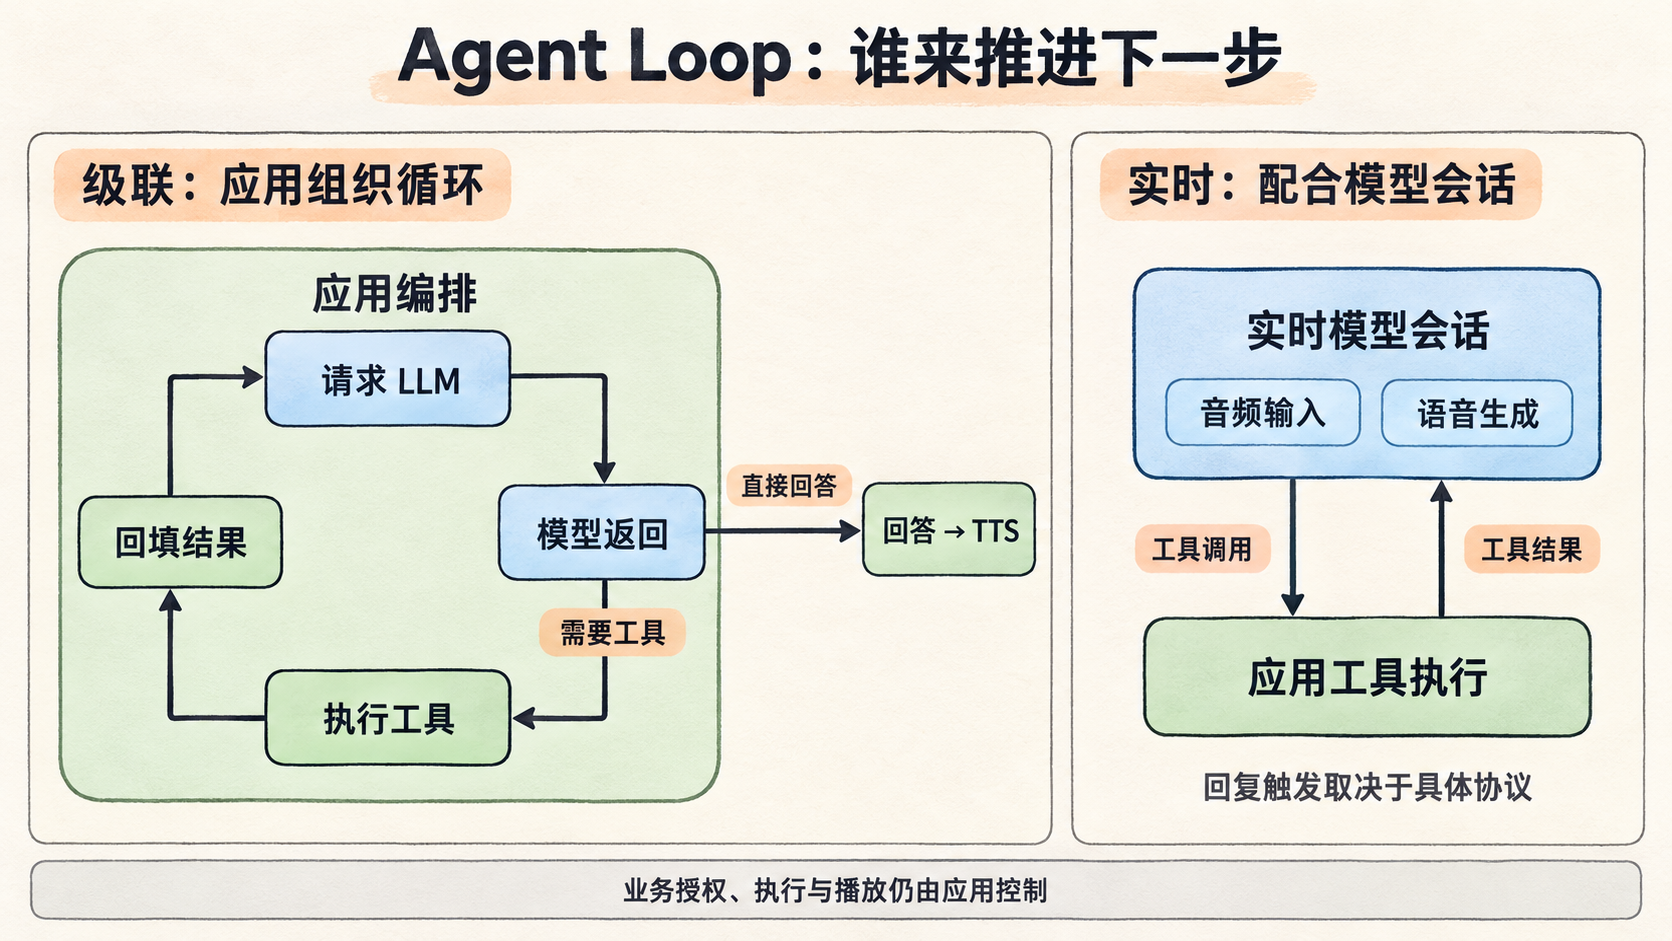
我们的助手还需要做事:模型发起工具调用,应用或工具服务执行后返回结果,模型再继续处理。这里把这个循环称为 Agent Loop。
级联模式:应用组织循环
如果采用级联模式,我们通过应用或框架组织 Agent Loop,LLM 负责理解和决策:
- ASR 把声音转成文字,作为这一轮的输入。
- 我们把文字和上下文交给 LLM;它需要用工具,就由应用执行,再把结果交回 LLM。
- 需要继续查资料或执行操作,就继续循环;得到回答后,把要说的内容交给 TTS(也可以分段合成)。
我们可以检查工具结果、选择写入上下文的内容,再决定开始合成语音的时间。出错时,也能按识别、模型调用和语音合成分段排查。
原生实时模式:通过会话接入工具
接入实时模型后,语音收发由模型会话处理。我们的业务工具还得接进去,模型才能查询资料、创建任务。
以 Qwen 的官方文档为例,有两种接法:
- Function Calling:告诉模型有哪些工具。模型返回工具名和参数,我们执行后把结果送回会话,再触发它继续回答。
- 远程 MCP:由 Qwen 实时服务发现并调用工具,应用处理授权和后续回复(官方目前列在 Qwen3.8-Omni-Flash-Realtime 下)。
对我们来说,Function Calling 这条路径仍然可以自己控制工具执行和结果回传,再按接口要求触发回复。用了全双工模型,也不必把业务 Loop 全交出去。
参考 Codex:语音接入同一个 Agent
研究 Voice Agent,自然也可以看看 Codex 是怎么做的。它用 GPT-Live 负责语音对话,实际执行任务的还是后台 Agent,使用的模型可以单独选择。Codex 本来就能通过文字对话调用 Agent,接入 Voice 后,相当于多了一个语音入口:原来打字交代的任务,现在可以直接说,做事仍然交给 Agent。
我们的需求也是这样,没必要为了语音再单独实现一套 Agent。不管用户打字还是说话,任务都交给同一个业务 Agent 处理。 这样工具、上下文和任务状态就能共用,用户先打字创建任务,后面再语音补一句修改要求,也能接着处理。语音这边主要负责听懂要求、传给 Agent,再把执行结果说给用户。
模型网关:先搭一个能共用的入口
会议模块是我们第一个开始实现 Agent 的模块,模型接入这部分也就落到了我身上。
最初,我打算在现有 Java 后端的网关层加上模型转发。但产品里会有多个用户,后续还会接入更多模型,跟着要做的事情也多了:
- 统一维护供应商的地址和密钥。
- 按用户配置模型访问权限。
- 把预算、限流和消费记录绑定到具体用户。
这部分继续放在业务网关里有点重,而且和会议本身没什么关系。所以,我把它拆出来,单独部署了一套 LiteLLM。
选择 LiteLLM 的原因
我选 LiteLLM,主要是它已经做好了模型接入、Virtual Key(发给调用方的受限凭证)、费用统计和管理界面,省得我们再写一遍。用起来有点像大家用过的模型中转站,只是自己部署和管理。
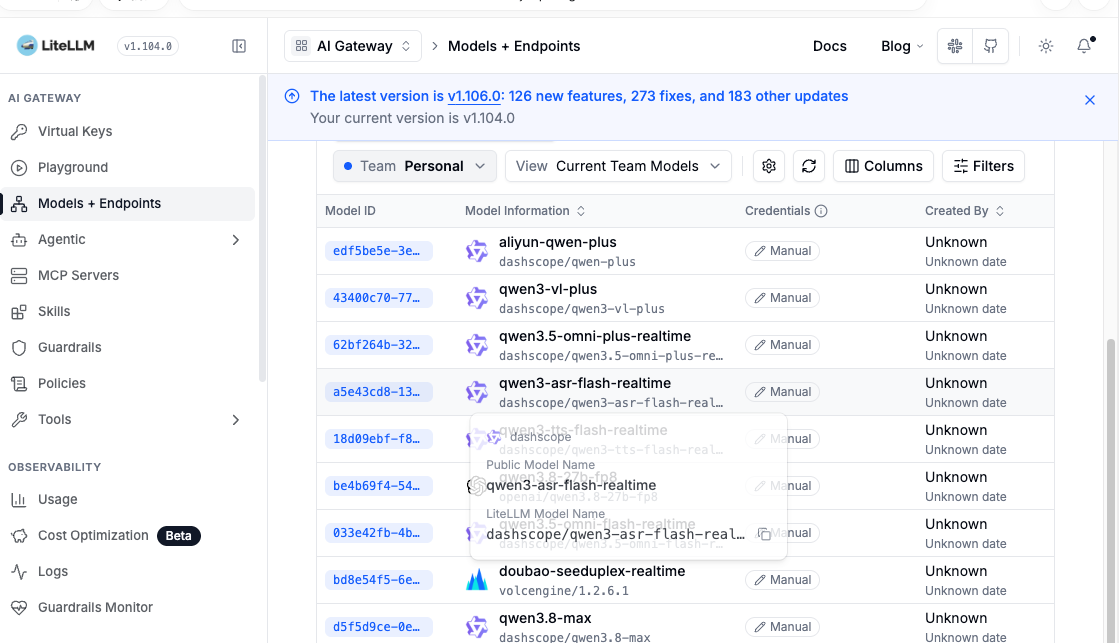
我们主要配置四类内容:
- 模型:配置供应商、可用模型和对外名称。
- 权限与凭证:配置用户的模型访问权限,以及凭证的使用范围和有效期。
- 预算:设置消费上限和预算更新周期。比如我们默认先给每个用户 10 美元,需要时再调整。
- 限流:设置每分钟请求数和 Token 上限,控制短时间内的调用量。
预算和消费记录放在 LiteLLM 中,跟用户绑定,更换凭证也继续累计。
复用 Java 登录体系,拿到凭证后直连
用户身份继续沿用已有系统。Java 后端校验登录和模型权限,再协调 LiteLLM 发放调用凭证;首次使用还没有对应账号,就自动创建。
客户端拿到凭证后直连 LiteLLM,由它转发模型请求。Java 只管用户和授权,不必再转发持续的音频流。
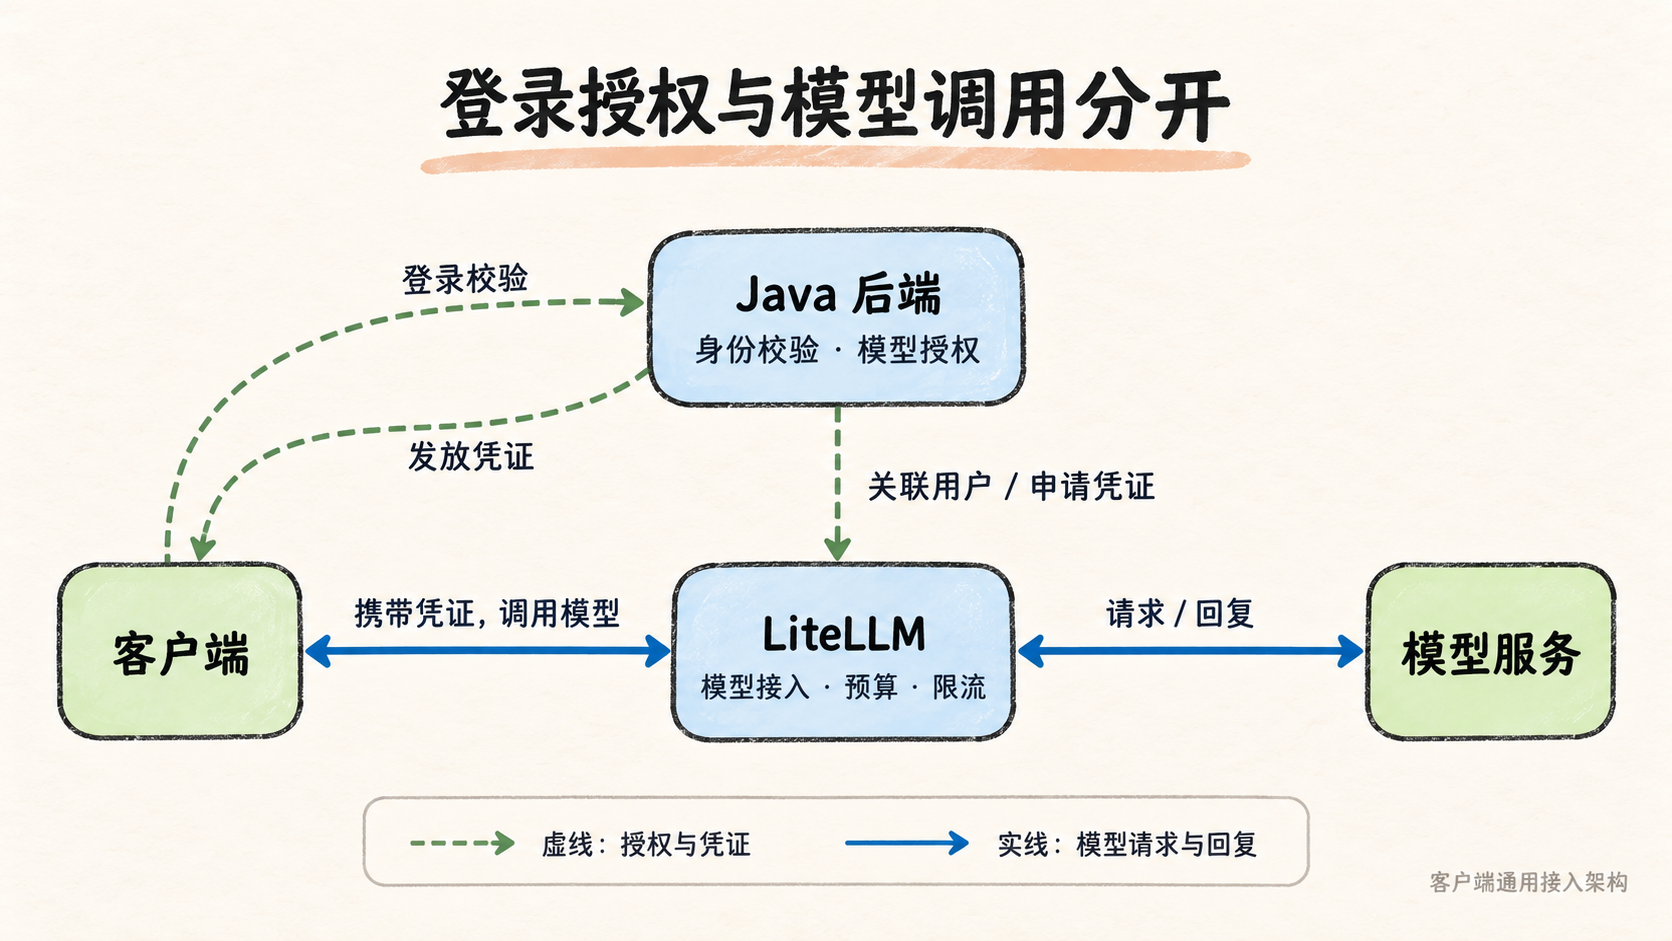
客户端通用接入架构。
市面模型选择与接入
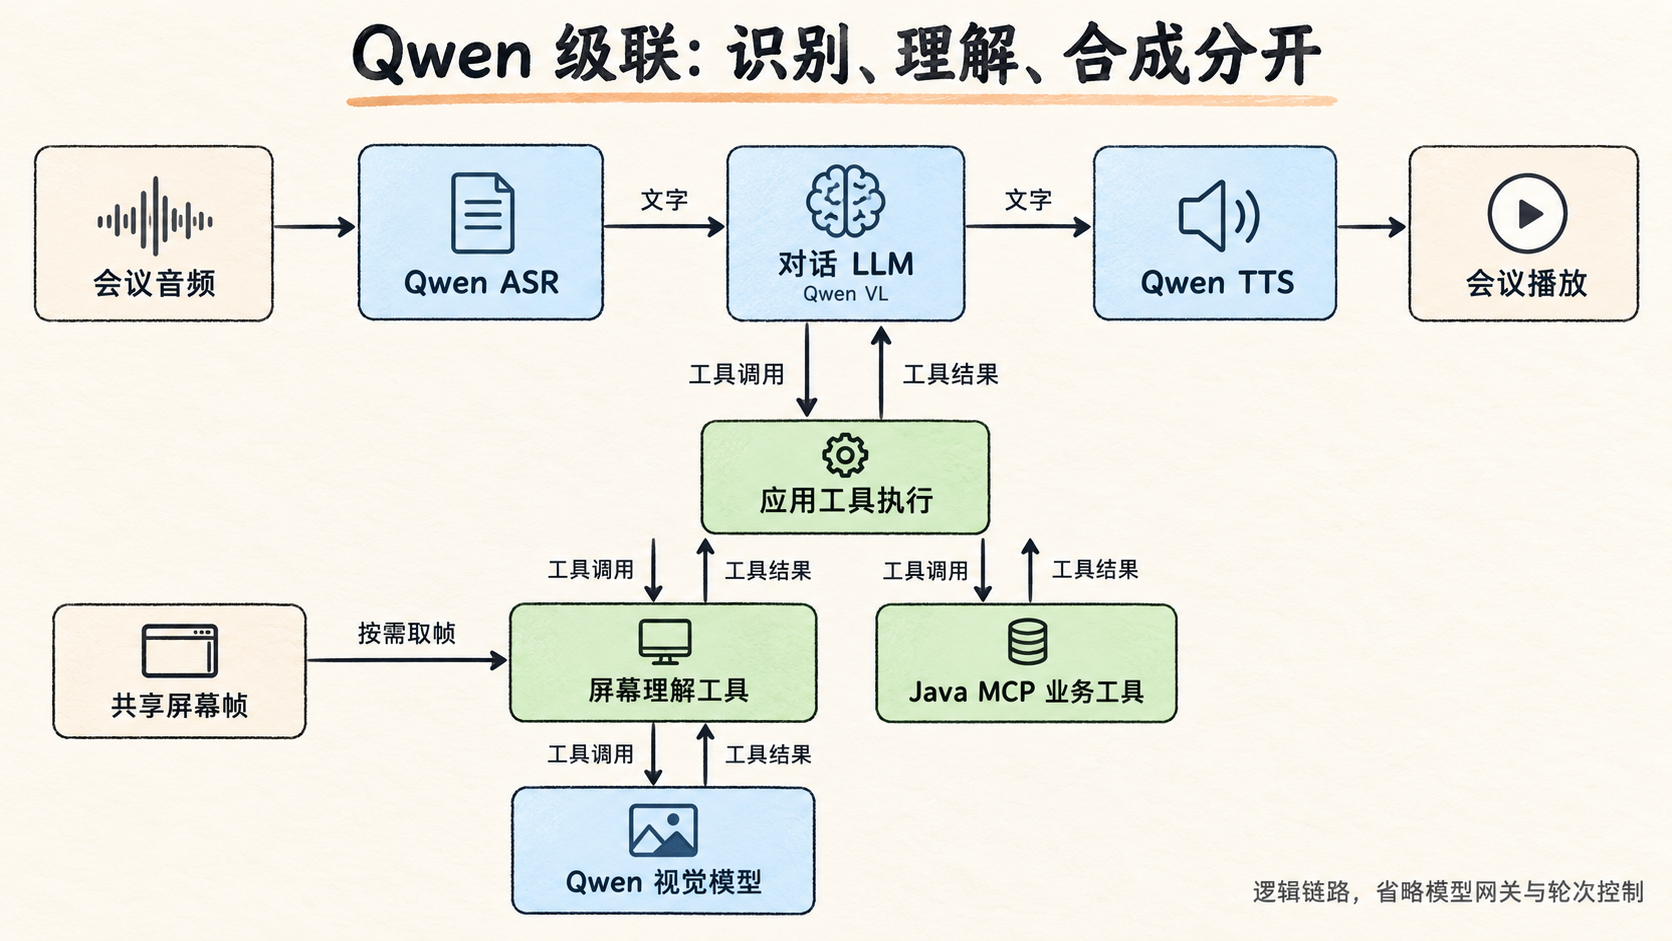
具体选型时,级联路线选择 Qwen 的 ASR、LLM 和 TTS,原生实时路线分别接入 Qwen 和豆包,一共比较三套组合。
会议里的 Agent 运行在独立的 Python 服务中,通过模型网关访问模型。Agora 收发会议音视频,Pipecat 组织处理环节,模型适配层处理各家的会话方式,Java 通过 MCP 提供业务工具。工具执行、字幕和播放等逻辑尽量共用。
Qwen 级联:分别选择识别、理解和合成
这版配置使用:
- ASR:
qwen3-asr-flash-realtime - LLM:
qwen3-vl-plus - TTS:
qwen3-tts-flash-realtime
我保留这套组合,是因为每一步的输入输出都能单独检查,方便和原生实时模型对照。
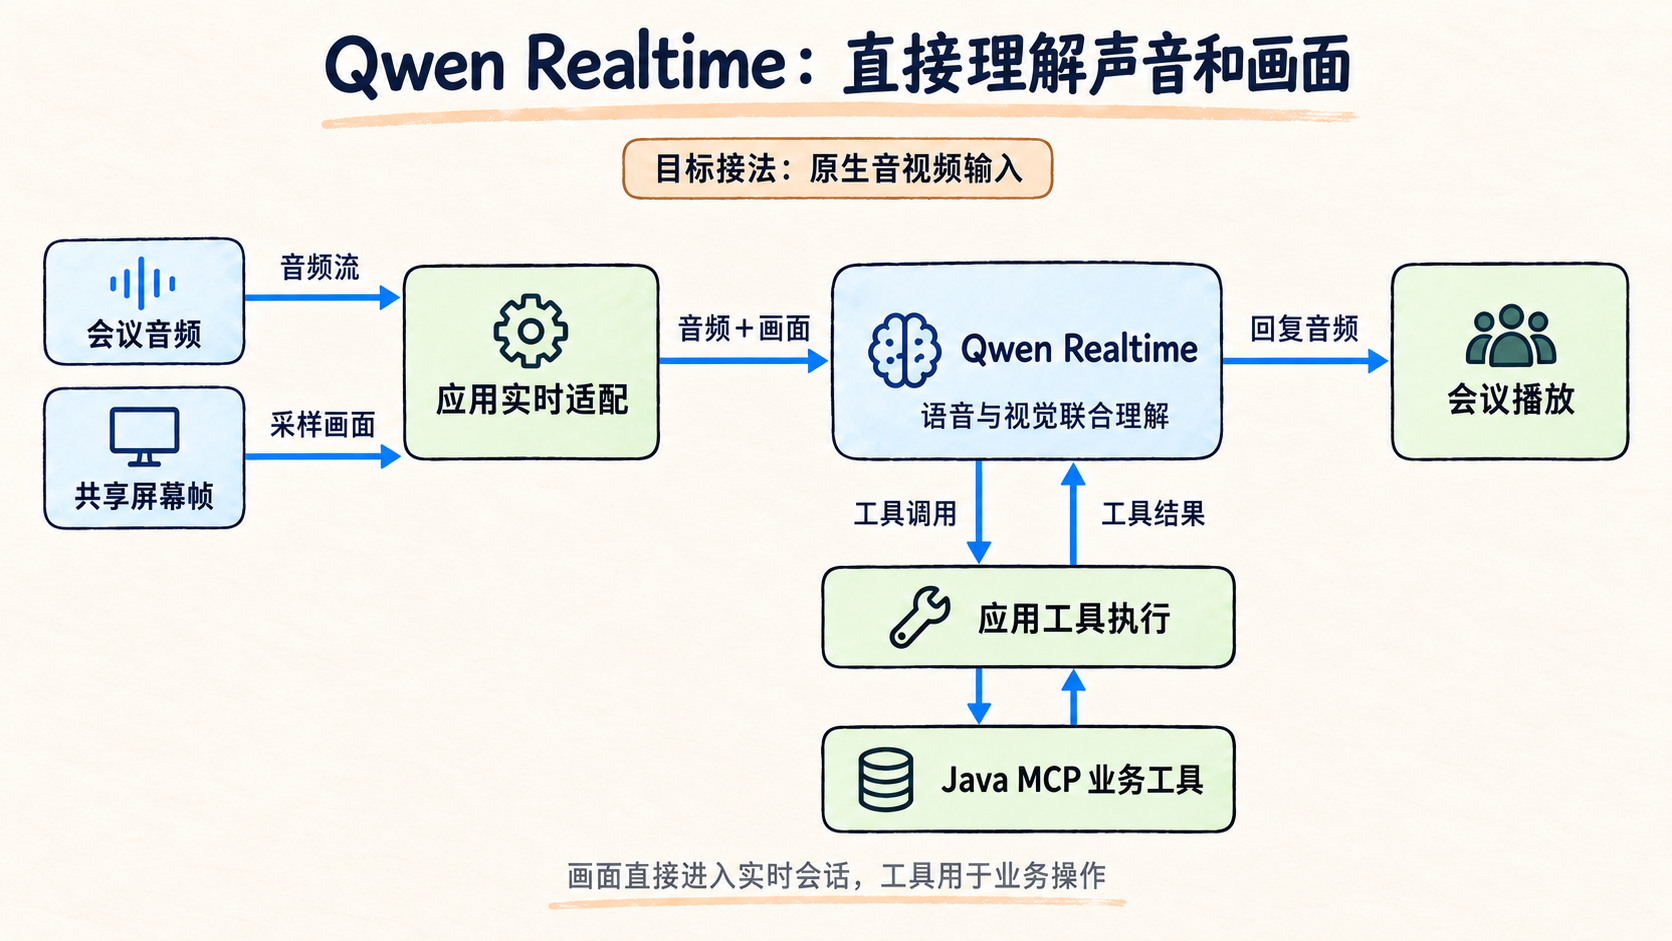
Qwen Realtime:直接理解声音和画面
另一条接入 qwen3.5-omni-flash-realtime。它本身支持音频和画面输入,可以把共享屏幕采样得到的连续帧,与用户的声音一起送进同一个实时会话。
这一版支持语音检测、语义打断和手动触发回复。官方明确标注全双工的是较新的 3.8 版本,本文接入的仍是 3.5。
用户指着屏幕说“把这里整理一下”,我希望模型能结合当前画面理解。Qwen 自己就能看,没有必要再调一次视觉工具,等文字描述回来。
所以这条链路接下来要改成:音频和画面直接送进 Qwen Realtime,工具只负责查资料、创建任务等业务操作。
豆包端到端:通过 Qwen 视觉工具看屏幕
我想做出豆包 App 那种聊起来很顺的感觉,就把它的端到端实时语音模型也接了进来,试试放到会议里、接上我们的工具后表现如何。
开放平台区分全双工、O2.0 和 SC2.0 等版本,本文记录的是所用接口的表现,不能直接等同于 App 的体验。
我们接入时,所用接口只开放了语音能力,没有开放同模型的视觉输入。会议助手又得看共享屏幕,我就把 qwen3-vl-plus 做成了屏幕理解工具:
- 豆包根据用户的问题发起工具调用。
- 应用取出当前共享屏幕的一帧,交给 Qwen 视觉模型分析。
- 观察结果返回给豆包,它再继续回答或调用业务工具。
看文档、表格可以用这套接法,但拿到的只是一帧,画面变了就得再调用一次。
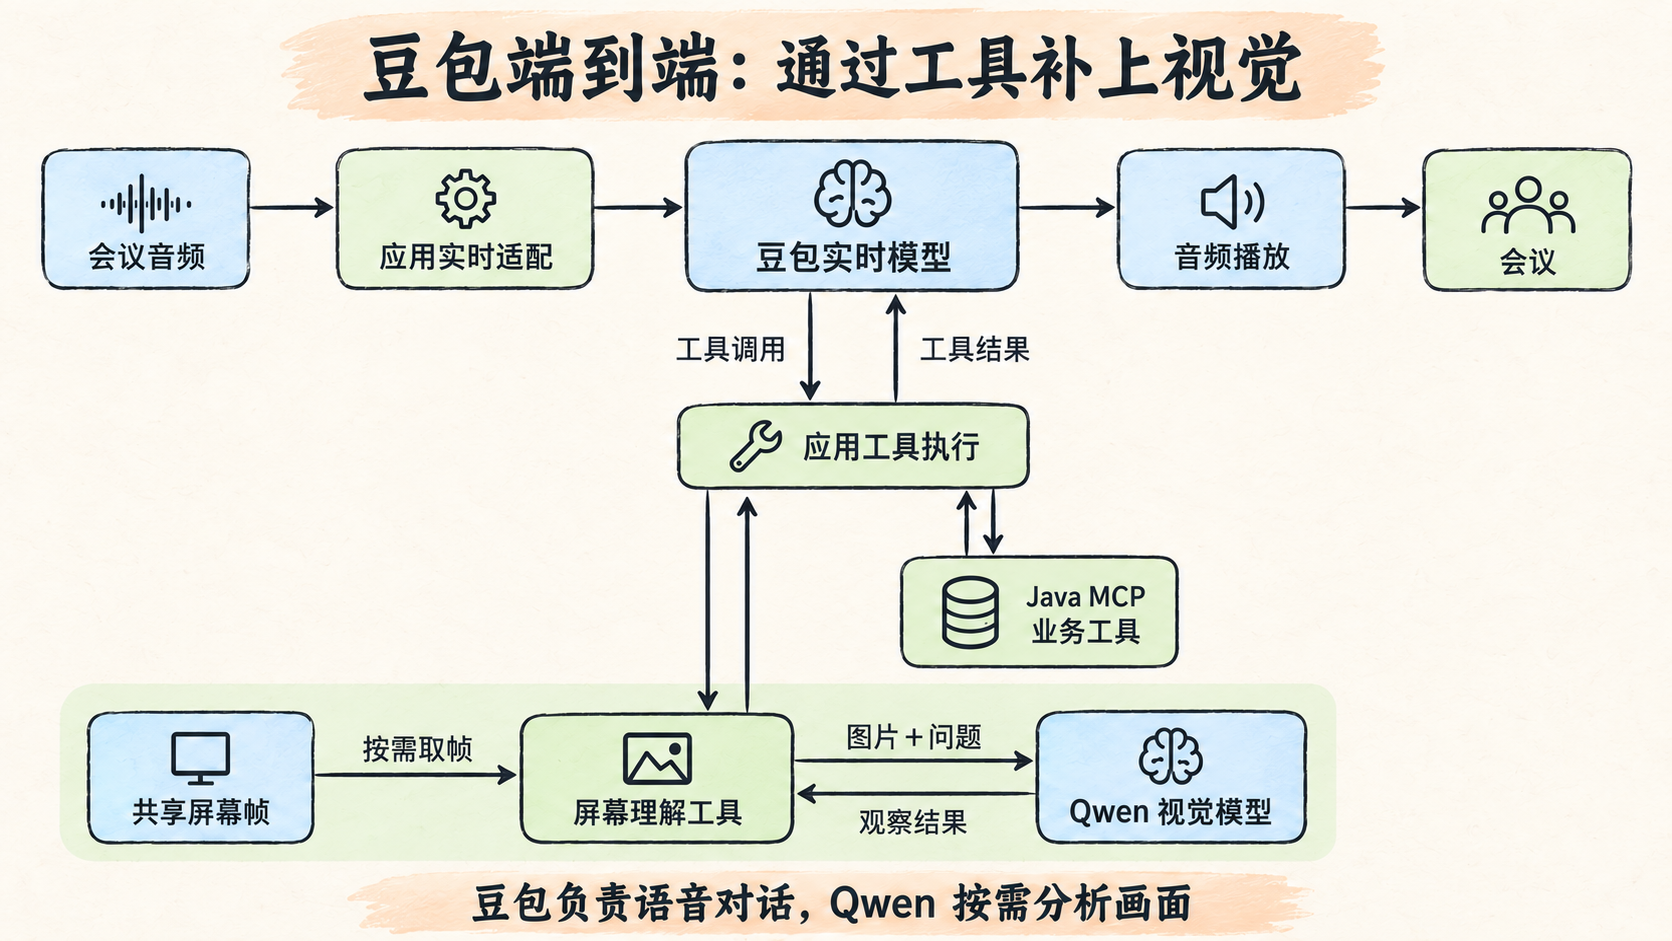
我会用相同的会议任务比较这两条路线,但不强求接法一致:Qwen 走原生视觉输入,豆包用工具补上所用接口缺少的视觉能力。
使用体验:从原生实时继续走向全双工
级联容易调试,但当前听感还不够自然
级联方便调试,但目前这套组合聊起来还是不够自然。我可以继续换 TTS、调播放策略,不过我更想试试模型直接理解和生成语音的效果。
我希望用户可以正常说话:先交代任务,想了一下再补负责人,最后又改了时间。助手顺着这些补充处理就好,不必让用户每次重新组织一遍完整指令。
这些停顿和改口能否处理好,是我比较模型时更在意的地方。
能接话以后,还要能把事情做完
我们验证 Qwen Realtime 创建任务时,遇到过用户补充完信息,模型就回答“已生成”,却没有发出工具调用,任务卡片也没生成的情况。
我要的是助手真的把任务建好,再告诉用户结果。所以试模型时,我会把业务工具一起接进去,看它能否补齐信息、调用工具,再根据执行结果回答。只试闲聊,看不出这些问题。
回复慢,也可能慢在应用里
豆包链路也出现过重复等待:完整转写已经到了,本地还在等一段静默时间,缓存中的回复迟迟没有播放。后来调整了这部分交接策略。
遇到回复慢,我会分别检查模型生成、本地等待和音频播放的耗时。先找到卡住的环节,再决定改代码还是换模型。
总结
其实这段时间踩了不少坑。看过前面的 Pipecat 文章应该知道,我最开始只是跑了一个 Demo 做验证,当时只知道级联模式。后来继续研究,才知道还有全双工模型;甚至在写这篇文章之前,我都不知道原生实时模型里还有半双工、按轮次交互的模型。很多内容都是边做边发现的,研究得越多,才知道还有这么多没弄明白的地方。
一个能基本跑通业务闭环的 Voice Agent,其实一个多月前就做好了,可以调用工具,也可以看我的屏幕共享。但这一个多月,我基本都在调整语音体验:一方面是工具调用的准确度,另一方面是对话始终没有达到 Tana 或豆包那种感觉。等它思考的时间、插话以后停下来的速度,都会让人觉得不够顺。
这也是我越来越倾向用全双工模型来做语音交互的原因。我自己试下来,目前用 TTS 合成的语音还是有比较重的“AI 味”:抑扬顿挫太刻意,听久了像在念稿,和自然聊天有距离。能听、能说、能调用工具之后,把对话体验调舒服,花的时间反而更多。
下一篇继续聊 Prompt 与工具调用,很快更新。
评论
暂无公开评论。